Слушать статью60 сек или целиком
Кратко о статье
- Одно поручение агенту может запускать много обращений к моделям и инструментам; цена доступа не равна цене выполненной задачи.
- Считайте расходы на принятый результат: модель, повторы, инструменты, инфраструктуру, проверку и исправления человеком.
- В условном сравнении из статьи снижение доли принятых результатов меняет экономику процесса, даже если расходы на ИИ остаются прежними.
- Оптимизацию через кеширование, маршрутизацию моделей и другие методы нужно проверять при сопоставимом качестве результата.
Когда говорят про инфраструктуру для искусственного интеллекта, разговор обычно довольно быстро сводится к видеокартам.
Сколько нужно H100 или H200?
Сколько памяти?
Хватит ли одного сервера?
Сколько будет стоить обучение модели?
Звучит логично. GPU дорогие, модели большие, а слово «искусственный интеллект» до сих пор неплохо соседствует со стойками серверов и фотографиями чёрных коробок с вентиляторами.
Но в реальной корпоративной жизни есть нюанс.
Большинство компаний вообще не собирается обучать собственную LLM с нуля.
Они собираются ею пользоваться.
И вот здесь начинается самое интересное.
ИИ становится не покупкой, а потреблением
Пользователь задаёт вопрос — модель генерирует ответ.
Сотрудник загружает договор — модель его анализирует.
Сервис пишет резюме встречи — снова обращение к модели.
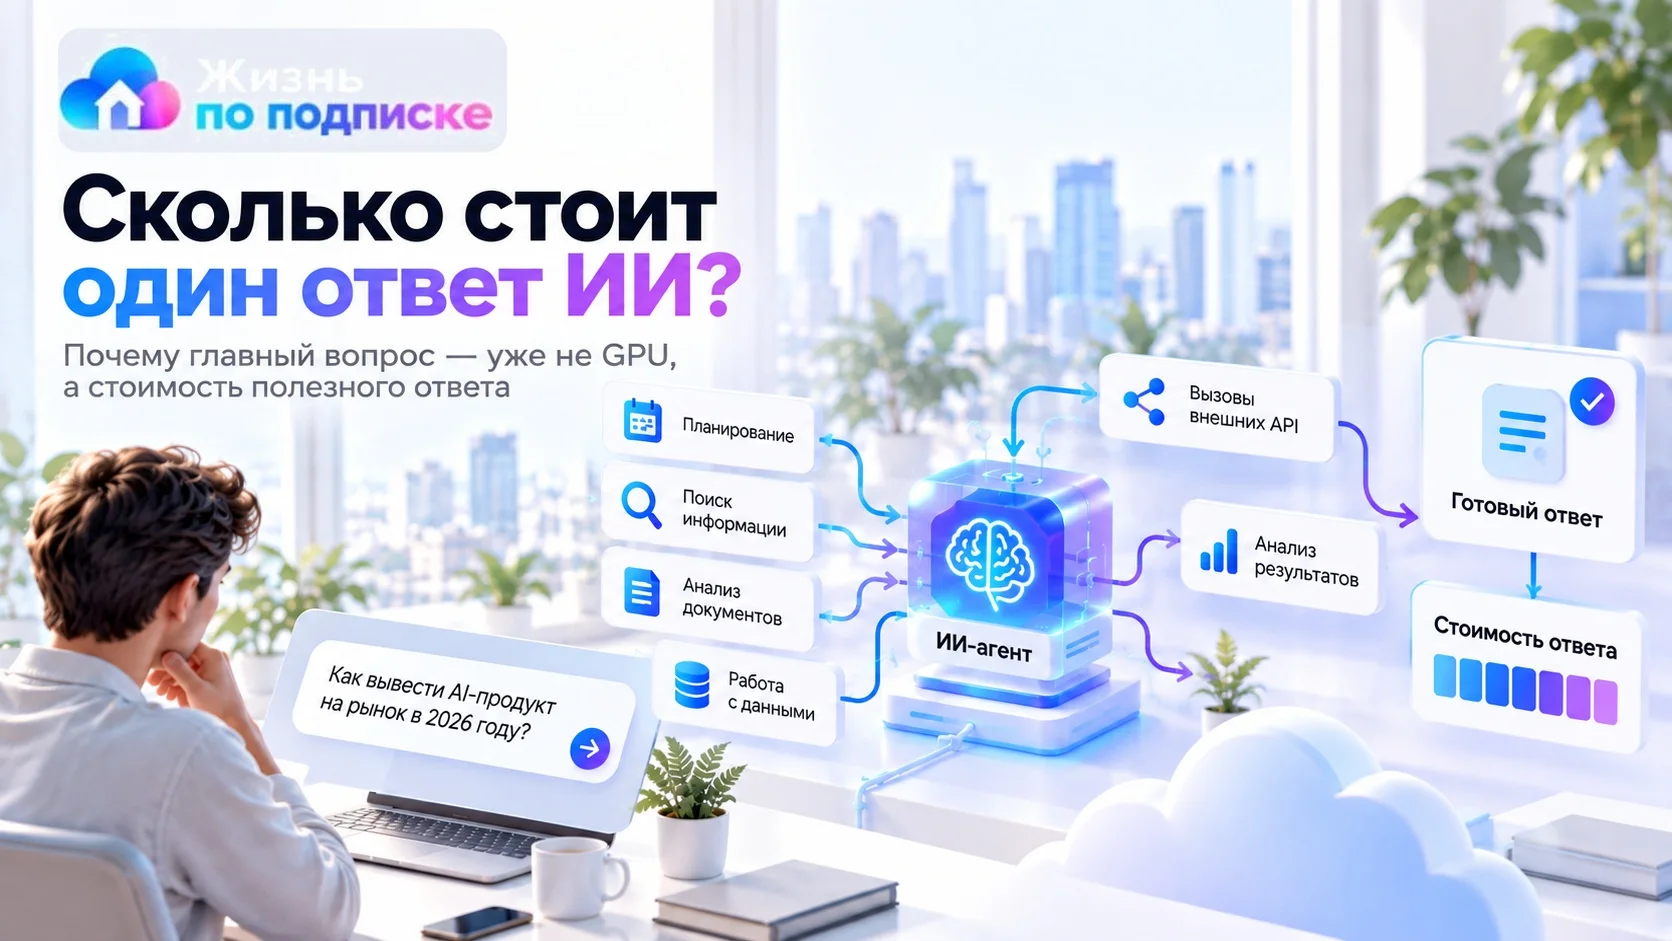
AI-агент проверяет почту, смотрит документы, обращается к базе данных, вызывает внешний API, сравнивает результаты и решает, что делать дальше.
Каждое такое действие — вычисления.
То есть ИИ всё больше напоминает не программу, которую однажды купили и установили, а сервис, который продолжает что-то потреблять каждый раз, когда им пользуются.
В каком-то смысле это очень знакомая история.
Мы уже привыкли платить не за диск с программой, а за подписку на SaaS.
Не обязательно покупать сервер — можно арендовать облачные ресурсы.
Музыку, фильмы, автомобили, рабочие инструменты и даже бытовые вещи всё чаще не нужно иметь в собственности.
Теперь похожая модель постепенно появляется и у интеллекта.
Только вместо привычного тарифа «999 рублей в месяц» внутри работает гораздо более сложный счётчик.
Один вопрос уже не всегда один запрос
С обычным чат-ботом всё относительно понятно.
Вы задаёте вопрос.
Модель отвечает.
Один запрос — один результат.
Но AI-агенты меняют эту механику.
Представим простую задачу:
«Посмотри мою почту, найди переписку по проекту, проверь последнюю версию договора и подготовь краткое резюме рисков».
Человеку кажется, что он дал системе одно поручение.
Но внутри агент может:
понять запрос;
составить план действий;
найти нужные письма;
выбрать документы;
проанализировать каждый из них;
обратиться к другой системе;
сравнить данные;
решить, что информации недостаточно;
сделать ещё один запрос;
сформировать финальный ответ.
И вот один человеческий запрос уже превратился в десять, двадцать или больше машинных операций.
Пользователь видит одну кнопку.
Инфраструктура — целую маленькую производственную цепочку.
Подписка заканчивается там, где начинается счётчик
На бытовом уровне мы привыкли мыслить подписками довольно просто:
Netflix стоит столько-то в месяц.
Облачное хранилище — столько-то.
Музыкальный сервис — ещё немного.
С ИИ всё может оказаться сложнее.
Потому что стоимость начинает зависеть не только от числа пользователей, но и от того, что именно они делают.
Один сотрудник может задать пять коротких вопросов.
Другой — загрузить сотню документов.
Третий запустить AI-агента, который в течение часа будет обращаться к нескольким моделям, поиску, базе данных и внешним сервисам.
Формально у всех может быть одинаковый доступ к системе.
Но стоимость их использования окажется совершенно разной.
И здесь привычная экономика подписок начинает превращаться в экономику потребления.
Поэтому главным вопросом становится не «сколько GPU?»
На старте AI-проекта легко обсуждать инфраструктуру.
Сколько GPU купить?
Какой сервер выбрать?
Какую модель запустить?
Но через некоторое время бизнес начинает задавать совсем другие вопросы.
Сколько нам стоит один запрос?
Сколько стоит один пользователь?
Сколько обходится одна задача AI-агента?
Какая модель съедает больше всего ресурсов?
Почему простой запрос отправляется в самую мощную модель?
Почему GPU загружены только на 30%?
И, наконец:
сколько стоит один действительно полезный ответ?
Вот здесь начинается новая дисциплина управления AI-системами.
Добро пожаловать в FinOps for AI
В облачном мире уже давно существует FinOps — подход, который помогает связывать потребление инфраструктуры с её реальной стоимостью.
С ИИ происходит нечто похожее.
Только теперь считать приходится не просто виртуальные машины, гигабайты памяти и терабайты хранилища.
Нужно понимать:
— сколько стоит обращение к модели;
— какая модель используется для конкретной задачи;
— сколько запросов делает AI-агент;
— сколько ресурсов расходуется впустую;
— где большую модель можно заменить маленькой;
— где результат можно взять из кеша;
— и насколько вообще стоимость ИИ соответствует той пользе, которую он создаёт.
Появляется экономика каждого действия.
И отсюда — целый набор новых оптимизаций
Например, batching позволяет объединять запросы и эффективнее загружать GPU.
Caching помогает не вычислять заново то, что система уже считала.
Quantization уменьшает требования модели к ресурсам.
Model routing позволяет не отправлять каждый вопрос самой большой и дорогой модели.
Зачем использовать условный «суперинтеллект», если задача — определить категорию входящего письма?
Для простых задач может хватить небольшой модели.
Для сложных — подключить более мощную.
То есть AI-инфраструктура постепенно начинает вести себя почти как современная система тарифов.
Не всё должно ехать первым классом.
Возможно, эпоха AI окажется эпохой счётчиков
Есть забавный парадокс.
Первые годы AI-бума мы обсуждали прежде всего размеры моделей.
Потом — количество GPU.
Теперь всё больше внимания будет уходить к стоимости эксплуатации.
Очень похоже на развитие других технологий.
Когда электричество только появлялось, всех впечатляли генераторы.
Позже людей стало гораздо больше интересовать, сколько стоит киловатт-час.
С облаками было то же самое.
Сначала компании обсуждали виртуализацию и серверы.
Потом начали смотреть на ежемесячный счёт.
С ИИ, вероятно, произойдёт похожая эволюция.
Сначала:
«Сколько H100 нам нужно?»
Через некоторое время:
«Почему расходы на AI выросли на 40%?»
А затем:
«Почему агент сделал 27 запросов к модели, чтобы выяснить, когда у сотрудника отпуск?»
И вот здесь технологии неожиданно снова превращаются в очень знакомый разговор.
Про деньги.
И, пожалуй, это главное
Возможно, один из главных показателей будущих AI-систем будет звучать не так:
сколько у нас GPU?
И даже не так:
какая у нас самая мощная модель?
А намного проще:
сколько полезных задач бизнес получает за потраченный рубль?
Потому что ИИ постепенно становится ещё одним сервисом.
Мы не обязательно будем им владеть.
Мы будем им пользоваться.
А значит — считать потребление.
И если раньше экономика подписок научила нас считать стоимость доступа, то AI, похоже, научит считать стоимость каждого действия.
Расчёт в текстовой версии: цена принятого результата
Все значения ниже вымышлены и не являются тарифами поставщика или результатами авторского эксперимента. За один период запущено 1 000 задач, принято после проверки 700 результатов. Обращения к модели стоили 30 000 рублей, проверка человеком — 15 000, инфраструктура — 5 000. Итого 50 000 рублей, или 50 000 / 700 ≈ 71,43 рубля на принятый результат.
Для реального сравнения определите критерий принятого результата и одинаковый состав расходов: повторные обращения, инструменты агента, проверку и инфраструктуру. Время и качество фиксируйте отдельно. Оплата токенов и стоимость готовой работы отвечают на разные вопросы. Этот расчёт дополняет исходную статью и доступен в тексте.
Для личного инструмента начните с гида о платном ИИ, для командного процесса — с гида о рабочих подписках.
Текстовое дополнение: сравнение процессов на условных данных
Текст обновлён 11 октября 2026 года. Аудиозапись относится к предыдущей редакции; исправления и новые примеры ниже доступны в тексте.
Продолжим вымышленный расчёт выше. Это аналитическая модель, а не результаты авторского эксперимента. Предположим, что ручной процесс и процесс с ИИ получили по 1 000 одинаковых заданий за один период, а по заранее заданным критериям в обоих принято 700 результатов.
| Расход или результат | Ручной процесс | Процесс с ИИ |
|---|---|---|
| Выполнение и повторные обращения | 50 000 ₽ | 30 000 ₽ на модель |
| Проверка и исправления человеком | 10 000 ₽ | 15 000 ₽ |
| Инструменты и инфраструктура | 3 000 ₽ | 5 000 ₽ |
| Полные расходы | 63 000 ₽ | 50 000 ₽ |
| Принятые результаты | 700 | 700 |
| Цена принятого результата | 90 ₽ | ≈ 71,43 ₽ |
При этих допущениях разница составляет около 20,6%. Вывод относится только к указанным расходам и одинаковому качеству принятого результата. Время выполнения, задержки и требования к данным нужно сравнивать отдельно.
Если расходы процесса с ИИ остаются 50 000 ₽, но принято только 500 результатов, цена вырастет до 100 ₽. При условной ручной цене 90 ₽ граница — не менее 556 принятых результатов: 50 000 / 556 ≈ 89,93 ₽. Это показывает, почему уменьшение счёта за модель само по себе не доказывает экономию процесса.
Как получить собственные данные
Зафиксируйте одинаковые задания и критерии принятия, версию модели и период. Записывайте затраты на все попытки, инструменты, проверку и исправления; общие расходы распределяйте по одному правилу. Сохраните принятые и отклонённые результаты, время и причины отказа. После этого подставьте свои данные вместо условных чисел. Не сравнивайте число генераций с числом готовых работ.
Разобраться в оплате доступа, ресурсов и результата поможет тематический гид Life as a Service / XaaS: что мы получаем как услугу.